SEO w erze AI – dlaczego Twój kod musi mówić językiem robotów? Przewodnik po danych strukturalnych dla LLM
Michał Piszczek
Z artykułu dowiesz się:
- SEO w erze AI – dlaczego Twój kod musi mówić językiem robotów? Przewodnik po danych strukturalnych dla LLM
- Jak AI „widzi” Twoją stronę? Fakty vs. mity
- 4 Kluczowe typy danych dla widoczności w AI (checklista)
- Czy to naprawdę działa?
- Pułapka techniczna – problem JavaScript
- Podsumowanie i rekomendacja
- Podobne wpisy
W marketingu cyfrowym następuje fundamentalna zmiana paradygmatu. Przechodzimy z ery klasycznego SEO (Search Engine Optimization) do ery GEO (Generative Engine Optimization). W PromoTraffic bacznie obserwujemy ten trend: użytkownicy coraz rzadziej szukają listy linków, a coraz częściej oczekują gotowej syntezy informacji od ChatGPT, Google Gemini czy Perplexity.
W tym nowym ekosystemie Twoja strona internetowa nie jest już tylko „czytana” przez ludzi. Jest „skanowana” przez modele językowe (LLM), które próbują zrozumieć: kto to napisał, o czym to jest i czy jest to prawdą.
Kluczem do przekazania im tych informacji są dane strukturalne (Schema.org). Z tego artykułu dowiesz się, jak wykorzystać ten techniczny standard, aby zwiększyć swoje Share of Model i budować widoczność tam, gdzie tradycyjne pozycjonowanie powoli przestaje wystarczać.
Jak AI „widzi” Twoją stronę? Fakty vs. mity
Wielu marketerów błędnie zakłada, że modele AI czytają stronę tak jak człowiek – linijka po linijce. W rzeczywistości proces ten wygląda inaczej, a dane strukturalne działają tutaj jako warstwa stabilizująca interpretację.
Są dwa główne sposoby, w jakie systemy AI wykorzystują Schema.org:
- Trening modelu (Learning): Dane strukturalne wchodzą do korpusów treningowych modeli poprzez procesy „data-to-text” (zamiana surowych danych na tekst naturalny). Fakty zawarte w kodzie JSON-LD są zamieniane na zdania, z których model uczy się o Twoim biznesie.
- Wyszukiwanie na żywo (RAG & Live Browsing): Gdy użytkownik zadaje pytanie w Bing Copilot lub Google AI Overviews, system szuka konkretnych faktów. Dobrze wdrożone schema pozwala na błyskawiczną ekstrakcję danych bez konieczności zgadywania przez model.
Co mówią giganci?
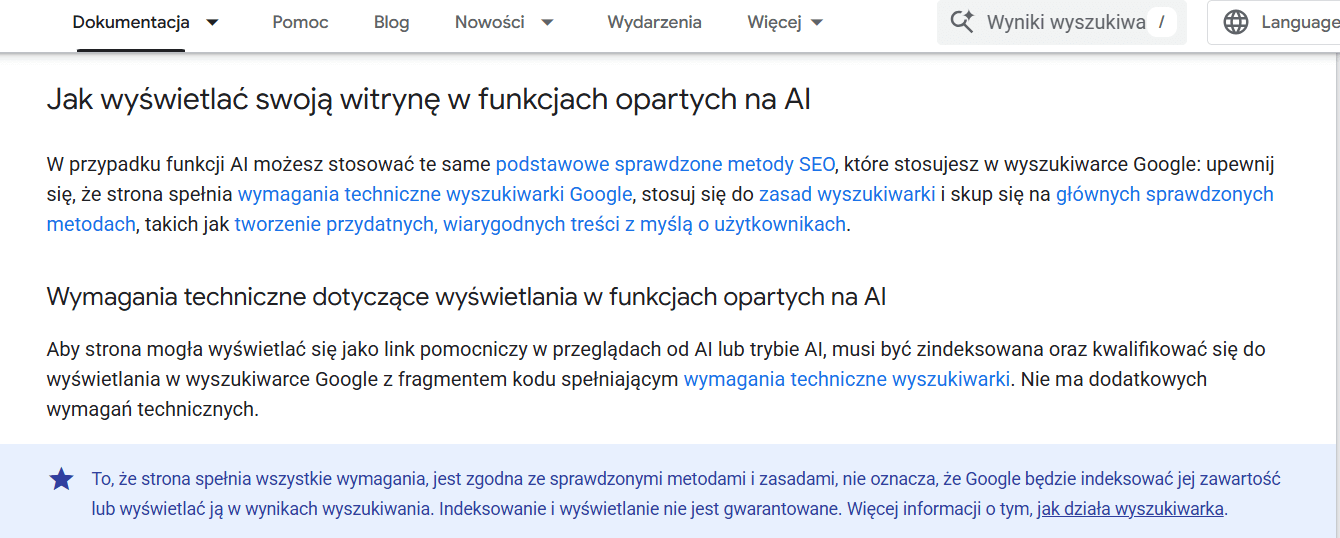
- Google: Oficjalna dokumentacja stwierdza, że nie ma „magicznych” znaczników pod AI. Liczy się jakość.
- Microsoft (Bing): Potwierdził oficjalnie, że „schema markup pomaga naszym modelom LLM zrozumieć treść”.
- OpenAI i Anthropic: Twórcy ChatGPT i Claude nie publikują oficjalnej dokumentacji dot. Schema.org. Wiemy jednak (o czym niżej), że ich boty zachowują się inaczej niż Googlebot.
4 Kluczowe typy danych dla widoczności w AI (checklista)
Nasza analiza dokumentacji i najnowszych eksperymentów z lat 2024-2025 wskazuje na kilka formatów, które mają krytyczne znaczenie w strategii GEO.
Dataset (zbiory danych)
Jeśli publikujesz raporty, statystyki lub analizy rynkowe, schema Dataset jest niezbędne. Pomaga ono AI zidentyfikować informacje liczbowe i benchmarki, które dla modeli tekstowych są „na wagę złota”.
- Zastosowanie: Raporty branżowe, wyniki badań, bazy danych.
- Efekt: Twoje dane mogą stać się źródłem dla precyzyjnych odpowiedzi typu „Jaka jest średnia cena usługi X w 2025 roku?”.
HowToStep (instrukcje krok po kroku)
Choć Google wycofało wizualne wyniki rozszerzone dla HowTo we wrześniu 2023 r., nie oznacza to, że przestało rozumieć ten kod. Ten typ danych jest nadal wartościowy dla modeli AI, które często strukturyzują odpowiedzi w formie list punktowanych. Dostarczenie gotowej, logicznej struktury (HowToStep) zwiększa szansę na poprawne odwzorowanie procedury przez bota.
- Zastosowanie: Poradniki, instrukcje obsługi, przepisy.
ScholarlyArticle (treści eksperckie)
W branży często mylnie szuka się typu „ResearchArticle”, który w standardzie Schema.org nie funkcjonuje jako główny typ. Właściwym formatem jest ScholarlyArticle.
- Dlaczego warto: Pozwala precyzyjnie określić autora, datę publikacji i cytowania. W kontekście rosnącego znaczenia weryfikacji źródeł, jest to silny sygnał autorytetu (E-E-A-T).
Organization / Person + atrybut sameAs
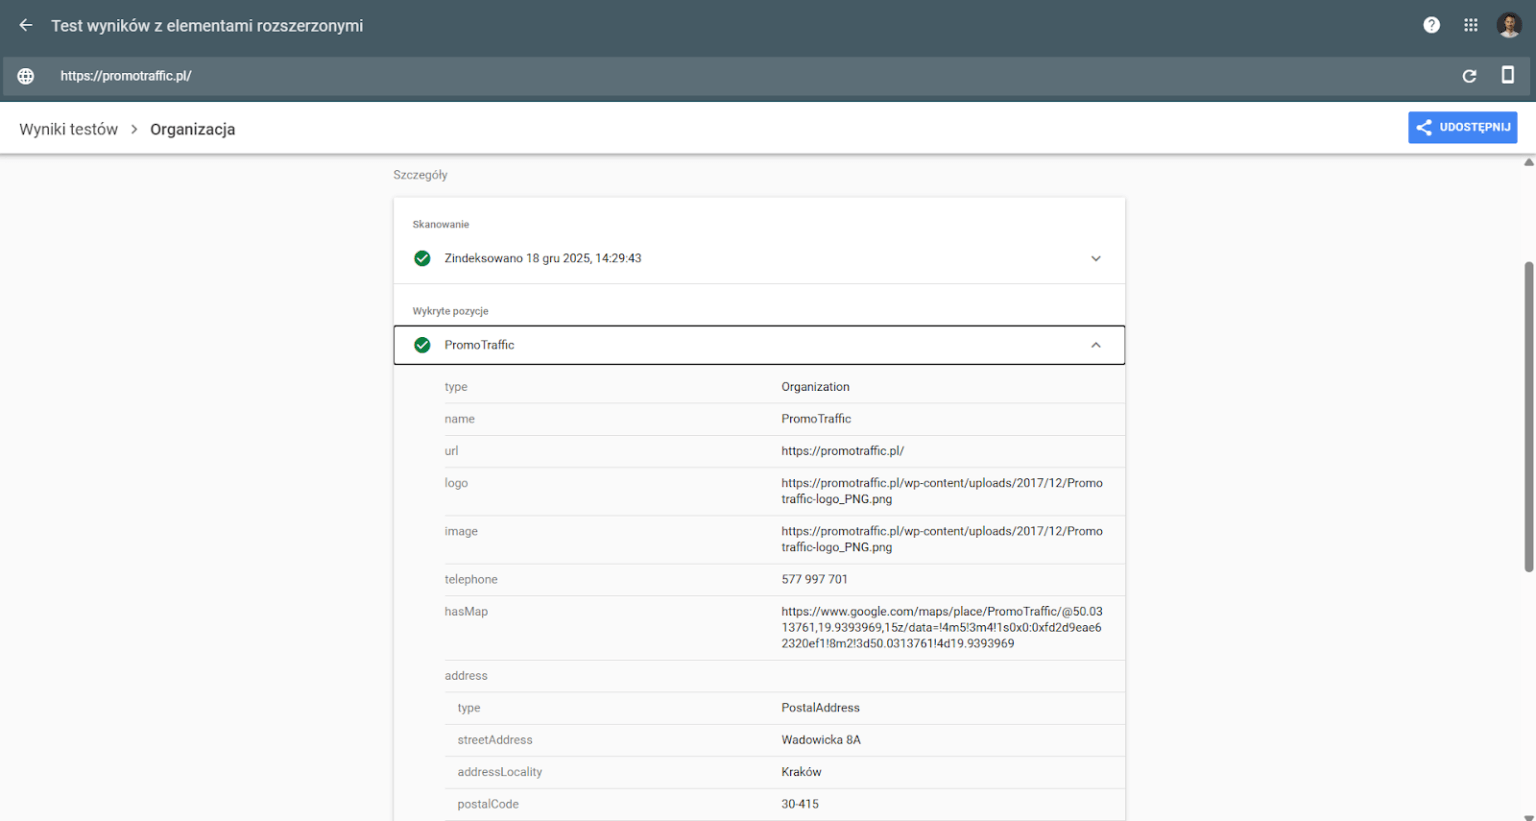
To absolutna podstawa Entity SEO. Samo oznaczenie autora to za mało. Kluczowy jest atrybut sameAs, w którym podajesz linki do profili na LinkedIn, Wikipedii czy Crunchbase.
- Cel: Dzięki temu AI „wie”, że Jan Kowalski z Twojej strony to ten sam uznany ekspert, którego profil widzi na LinkedIn. Bez tego model może uznać autora za anonimowy byt.
Czy to naprawdę działa?
Wnioski z eksperymentów
Nie musimy opierać się na domysłach, choć wyniki różnią się w zależności od platformy:
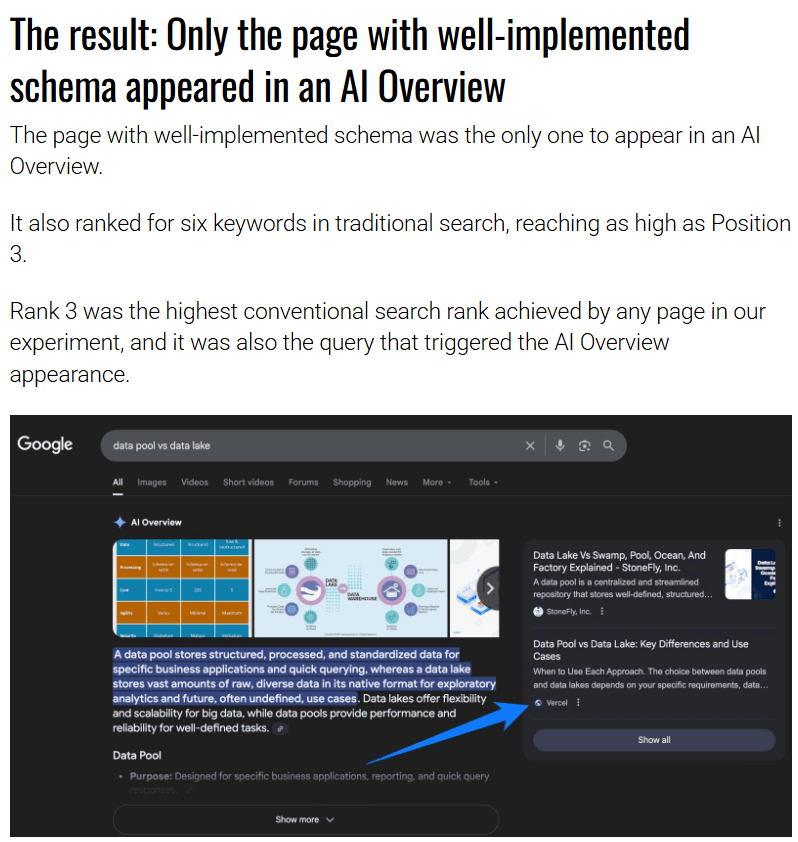
- Google AI Overviews (SGE): Testy Search Engine Land (wrzesień 2025) wykazały, że w kontrolowanym środowisku tylko strona z poprawnie wdrożonym schema pojawiła się w odpowiedzi generowanej przez AI.
- Modele Gemini: Badanie Wildcat Digital wskazało, że strony z wdrożonym FAQPage miały o 170% wyższy wskaźnik cytowań przez model Gemini 2.0.
- Bing Copilot / Perplexity: Tutaj korelacja jest najsilniejsza i potwierdzona wypowiedziami przedstawicieli Binga.
- ChatGPT: Tu należy zachować ostrożność. Badania SMA Marketing sugerują, że ChatGPT (w przeciwieństwie do Binga) nie wykazuje obecnie statystycznie istotnej reakcji na dane strukturalne. Choć w trybie „Browse with Bing” model korzysta z indeksu Microsoftu, jego „temperatura” i losowość sprawiają, że schema nie gwarantuje cytowania.
Pułapka techniczna – problem JavaScript
To najważniejsza techniczna uwaga tego artykułu. Badania Vercel (grudzień 2024) potwierdzają, że większość botów AI (GPTBot, ClaudeBot, PerplexityBot) nie wykonuje JavaScriptu w taki sposób jak Googlebot.
Co to oznacza dla Ciebie? Jeśli wdrażasz dane strukturalne za pomocą Google Tag Managera (GTM) lub skryptów po stronie klienta, są one niewidoczne dla większości modeli AI.
PRO Tip: Dane strukturalne muszą być renderowane po stronie serwera (Server-Side Rendering) i umieszczone w statycznym bloku <script type=”application/ld+json”> w kodzie HTML.
Podsumowanie i rekomendacja
Wdrożenie zaawansowanych danych strukturalnych (Dataset, ScholarlyArticle, HowTo) w latach 2024-2025 to konieczność w budowaniu widoczności w nowoczesnym internecie.
Checklista dla Twojej strony:
Zadbaj o fundamenty
Article, Organization, Person (z atrybutem sameAs), FAQPage.
Wdrażaj specjalistyczne typy
Używaj Dataset dla danych liczbowych i ScholarlyArticle dla treści eksperckich.
Technologia ma znaczenie
Upewnij się, że kod JSON-LD jest dostępny w surowym HTML, a nie wstrzykiwany przez JS.
Jakość ponad ilość
Puste lub błędne schema jest gorsze niż jego brak. Dane w kodzie muszą pokrywać się z treścią widoczną dla użytkownika.
Dane strukturalne nie są magicznym przyciskiem, który zmusi ChatGPT do mówienia o Tobie, ale stanowią niezbędną infrastrukturę, dzięki której Twoja treść staje się zrozumiała dla maszyn. W nowym internecie to kod jest Twoją wizytówką.
Chcesz przygotować swoją stronę na rewolucję AI Overviews? Skontaktuj się z nami – przeanalizujemy Twoje dane strukturalne.